2026-11-01 · 10 min
mendcode, un cli de agentes que armas a tu manera
Por qué construí MendCode a mi manera. Perfiles, tiers, distintos motores y revisiones de código, con las razones detrás y las mediciones frente a otros CLI.
Usé todos los CLI de código que pude. Cada uno tenía algo que quería conservar y algo que quería cambiar. pi es pequeño y no estorba. Claude Code y Codex tienen un flujo equilibrado para el día a día. OpenCode te muestra todo. Ninguno me dejaba tomar un poco de cada uno y hacerlo mío.
Así que hice MendCode. Es gratis, open source con licencia Apache 2.0 y el código está en GitHub. El modelo lo conectas tú; su uso sigue sujeto a los costos y límites de tu proveedor.
Soy Obed, desarrollador de Panamá. Empecé a programar en la pandemia, antes de que la IA pudiera escribir una línea por mí, y casi todo lo que hago termina público en mi GitHub. Me gusta que alguien pueda tomar algo mío y llevarlo a un lugar que a mí no se me ocurrió.
Tiers: no quiero elegir entre pequeño y completo
Quería poder cambiar la herramienta con la que paso horas trabajando. A veces quiero solo un prompt y una respuesta; otras necesito ver varias sesiones, revisar un diff o seguir un trabajo largo. No quería elegir otro CLI cada vez. Por eso MendCode tiene tres puntos de partida, minimalist, balanced y full, y deja prender o apagar cada función por separado.
Minimalist es para tener al agente sin tanta interfaz alrededor. Balanced añade cosas que uso al trabajar en un repo, como el grafo de código y los sub-agentes. Full deja más a mano para experimentar. Son puntos de partida, no paquetes cerrados: si solo quiero una función de otro tier, puedo activarla sin llevarme todo lo demás.
Eso es lo que quería conservar de las herramientas que probé: poder acercarme a la sencillez de pi o tener más información visible sin cambiar de aplicación. Que MendCode crezca no debería obligarte a usarlo todo.
Profiles: compartir mi CLI, no solo sus colores
Un tema cambia el aspecto. Yo quería poder cambiar también cómo se trabaja: las teclas, el prompt, las vistas, las herramientas y los comandos. Los perfiles agrupan esas decisiones para poder guardar mi setup o probar el de otra persona. Se aplican encima del mío; al desactivarlos recupero lo que tenía.
La reversibilidad importa. Si probar un setup significa sobrescribir mi configuración y luego reconstruirla a mano, termino sin probar nada. Quiero que compartir un perfil sea una forma de compartir lo que a alguien le funciona, y que quien lo instale pueda conservar sus propias decisiones.
También quiero poder decirle al agente «quita ese panel» o «cambia cómo se ven las respuestas». Por eso la documentación viene dentro del programa y la personalización tiene una vista previa. El agente puede consultar cómo cambiarlo, en vez de inventarse ajustes. Cuando un ajuste no alcanza, hay extensiones y vistas reemplazables. No debería hacer falta esperar a que yo apruebe una idea para tenerla en tu terminal.
Elegir una interfaz sin casarme con un motor
Tampoco quería abandonar un motor que ya me sirve. MendCode tiene uno propio, pero puede ejecutar Claude Code, Codex, pi o agentes ACP dentro de la misma pantalla, cada uno con su login y sus capacidades. Yo uso Claude Code y Codex así todos los días. Elegir la interfaz no debería obligarme a elegir un solo proveedor.
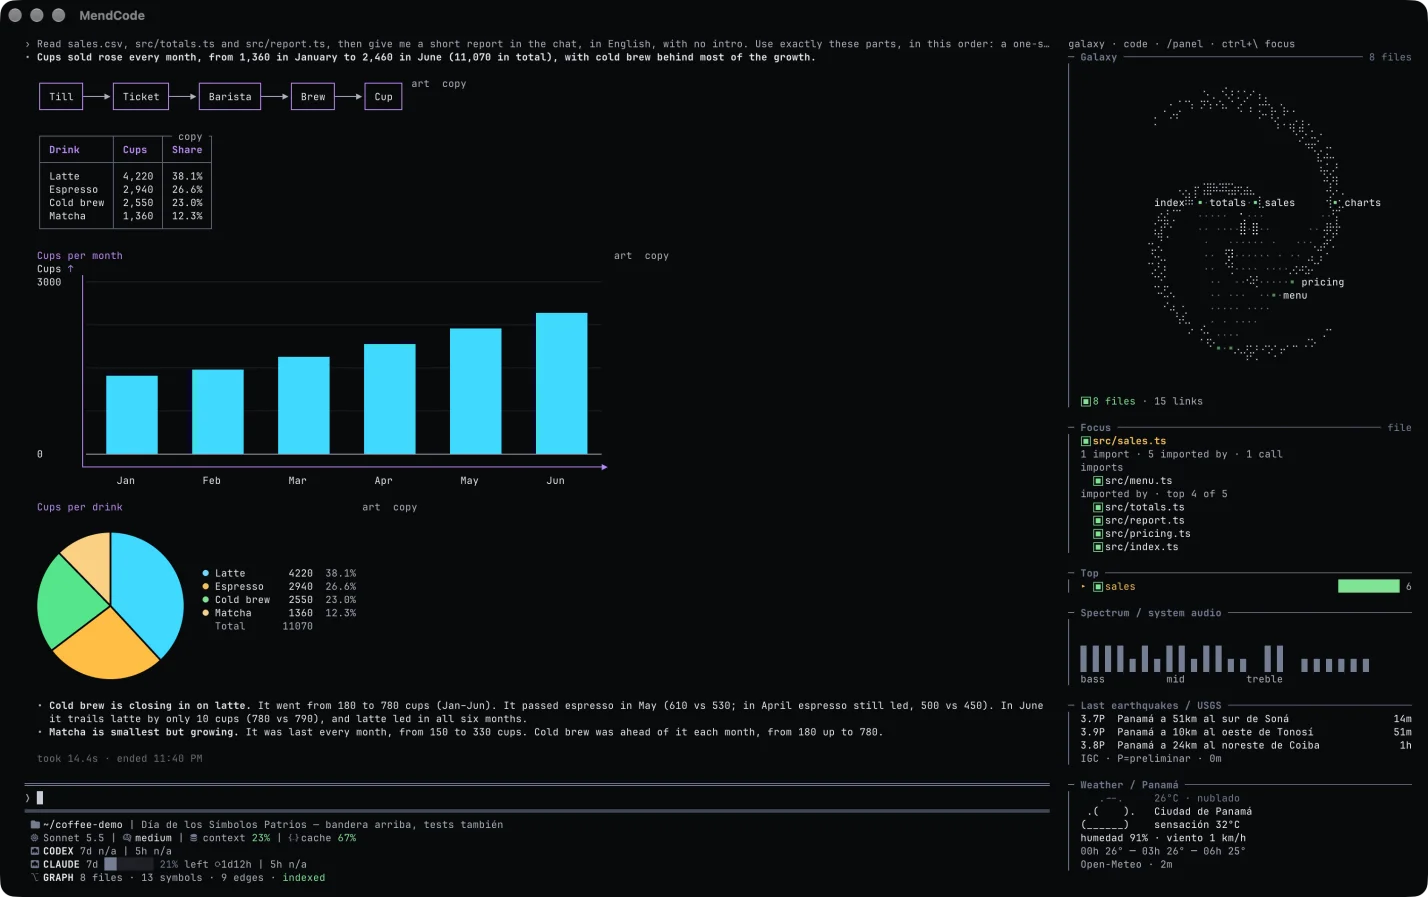
La captura es de mi terminal. Quería poder leer una tabla o un diagrama donde ya estaba trabajando, sin salir a otra aplicación.
PR review: encontrar algo no basta para publicarlo
Un agente que encuentra diez posibles problemas no necesariamente hizo una buena review. Si tengo que desmontar nueve para encontrar uno real, me trasladó el trabajo. Quiero que un comentario justifique cambiar el código, y que el revisor pueda terminar sin decir nada cuando no encuentra un defecto.
Por eso /pr review separa encontrar de verificar. Una primera sesión lee el cambio y propone hallazgos con evidencia en el código. Una segunda sesión, nueva y de solo lectura, recibe la tarea de intentar refutar cada uno. En el perfil normal se publican solo los que esa segunda pasada confirma; el estricto también puede incluir los plausibles, marcados como tales. Es una comprobación adicional, no una garantía de que el modelo tenga razón.
Además, la revisión recibe el diff y, cuando hay un grafo disponible, las funciones que llaman al código cambiado y las que este llama. Por ejemplo, cambiar lo que devuelve una función puede romper un consumidor que ni aparece en el diff. Ese contexto ayuda a buscar el fallo fuera de las líneas editadas, en vez de limitarse a comentar su aspecto.
La revisión sigue lo que ocurre después: un push normal revisa lo nuevo y vuelve a comprobar los hallazgos abiertos en los archivos afectados. Si dejaron de reproducirse, puede cerrar sus hilos en GitHub. No quiero discutir un problema corregido ni revisar el mismo cambio entero en cada push.
Y quiero controlar quién revisa y con qué. En mi máquina usa el modelo elegido y mi login de gh, sin contratar otro servicio de review ni instalar una GitHub App. El repositorio decide las reglas desde la rama base: el PR no puede desactivar su propia revisión. Publicar requiere permiso; corregir y hacer push es otra capacidad que se habilita aparte.
Por eso lo prefiero a pedirle a un CLI «revisa este diff» y encargarme yo del seguimiento. No tengo una evaluación que demuestre que encuentra más bugs que todos los demás revisores. Si se queda sin presupuesto, debe decir qué quedó sin revisar, no llamar limpio al PR.
La referencia del reviewer explica los controles y límites. Para dejarlo trabajando con la terminal cerrada basta con que la máquina y el daemon sigan activos; si la máquina está apagada, hace falta un servidor o el workflow de GitHub.
Más funciones no deberían hacer pesado lo básico
De ahí también salen la carga bajo demanda y el trabajo sobre memoria: no quiero pagar por un servidor web o un reviewer cuando solo estoy escribiendo una pregunta. El daemon conserva las sesiones para que su trabajo no dependa de una ventana abierta.
Esta es la comparación publicada el 3 de noviembre de 2026, en un Mac M4 Pro con 24 GB, con las herramientas autenticadas y la misma pregunta de solo lectura. RSS y footprint muestran memoria al llegar al prompt / después de responder; disco es lo guardado por esa sesión.
| CLI | RSS | Footprint | Disco por sesión |
|---|---|---|---|
| MendCode minimalist | 129 / 138 MB | 63 / 67 MB | 2.5 KB |
| MendCode balanced | 130 / 139 MB | 64 / 66 MB | 2.6 KB |
| MendCode full | 131 / 140 MB | 64 / 69 MB | 2.6 KB |
| pi | 133 / 139 MB | 81 / 88 MB | 2.85 KB |
| Claude Code (Haiku) | 289 / 314 MB | 146 / 152 MB | 302 KB |
| Codex CLI | 310 / 507 MB | 215 / 330 MB | 43 KB |
| OpenCode 1.19.5 | 1,220 / 1,324 MB | 551 / 591 MB | 28 KB |
El método y los resultados incluyen el proceso completo, no solo la pantalla. Se usó gpt-6-luna salvo en Claude Code, que usó Haiku; MendCode y pi muestran medianas de tres lanzamientos. Es una medición concreta, no una promesa para cualquier proyecto. También hay un resultado peor: en esa prueba MendCode consumió entre 1.1 y 1.5 segundos de CPU por turno frente a 0.2 de pi.
El contexto también cuesta
No quiero gastar contexto para que el agente averigüe dónde está una función cada vez. El grafo le da símbolos y llamadas con archivo y línea, para leer lo que necesita. La compactación conserva el pedido original y las tareas pendientes: resumir una conversación no debería cambiar lo que le pedí. Y cuidar la caché importa porque una sesión larga vuelve a enviar contexto en cada paso.
En una evaluación del 6 de octubre de 2026 contra Codex CLI, con gpt-6-luna, esfuerzo medio y 12 tareas repetidas tres veces, el resultado fue:
| Codex CLI | MendCode balanced | |
|---|---|---|
| Resueltas | 32/36 | 33/36 |
| Tokens de input | 3.40M | 1.00M |
Lo interesante para mí es mantener un resultado parecido enviando menos contexto. Son tareas cortas, un modelo y una máquina: no demuestra superioridad general ni mide la calidad del PR review. Tampoco significa una factura 70 % menor; el input sin caché fue 0.46M frente a 0.38M. Los límites de la evaluación están publicados.
Trabajo largo sin tener que llevarlo todo en la cabeza
Un chat alcanza para un cambio pequeño. Cuando hay varias tareas, quiero separar quién hace qué, ver qué falta y saber qué comprobación decide que algo está terminado. Los sub-agentes y workflows están para eso, con presupuestos y condiciones de parada. Las sesiones pueden hablarse para que yo no tenga que copiar respuestas entre ellas. Los worktrees quedan como opción cuando necesito aislar cambios, no como obligación para cada agente.
La memoria resuelve otra repetición: volver a explicar cómo trabajo. Quiero decidir qué se guarda y poder corregirlo o borrarlo; Dream puede proponer recuerdos a partir de sesiones recientes, pero se activa aparte. Las áreas separan las memorias, modelos y permisos del trabajo de los personales. Que el agente me conozca mejor no debería significar mezclar todos mis proyectos.
Son decisiones conectadas. Puedo usar el mismo modelo que en otro CLI, pero cambiar qué información recibe, cómo se reparte el trabajo y qué puedo controlar yo. Ahí está la diferencia que busco en MendCode, más que en sumar funciones a una lista.
Claves y chats: lo que se queda en mi máquina
Un .env en el repo sigue siendo el lugar para lo que necesita el proyecto en sí: tu app, tus scripts o tu CI lo leen, y vive con el código. Lo que no quería era pegar una clave en el chat, ni dejarla en un archivo solo para que el agente pudiera correr un comando. Para eso está /env. Agregas un nombre y un valor oculto, o pegas un .env entero y eliges qué nombres guardar. Los valores van a una bóveda local cifrada y nunca aparecen en pantalla, en el historial del prompt ni en el chat. Aplican al proyecto por defecto, o a una sesión, o a todo.
En el motor propio de MendCode, el modelo solo recibe los nombres, sus comandos de shell reciben los valores como variables de entorno, y si un valor aparece en la salida de un comando se convierte en ‹env:NAME›. Claude Code, Codex, pi y los agentes ACP también los reciben en el entorno de su proceso, pero imprimen con sus propias herramientas, así que ahí MendCode no puede taparlos. Importar un .env no cambia ni cifra el archivo original. Y un comando que puede leer un valor todavía puede filtrarlo, así que las aprobaciones y el sandbox siguen importando.
/privacy es otra cosa: cifra tus chats en disco. Viene apagado. Si lo prendes, cifra la base de datos local (sesiones, historiales, borradores, memorias, ajustes) y los adjuntos y salidas guardadas, así que cat, grep o un lector de SQLite ya no pueden leerlos. Es cifrado en reposo, no de extremo a extremo: el provider sigue viendo lo que se le envía. Quedan fuera las exportaciones, los backups anteriores, los archivos de tu repo (tu .env incluido) y los logs propios de los motores. La clave vive en keys/; respáldala aparte, porque sin ella los chats no abren. En historiales grandes también cuesta más RAM, CPU y escrituras en disco.
En el tier minimalist los dos comandos están ocultos; /tier balanced o el editor de comandos los trae de vuelta. Las teclas y los límites están en la referencia de entorno y privacidad.
Lo que costó llegar hasta aquí
Estos son los números acumulados hasta la v0.0.4 Beta 1, no el tamaño actual del programa ni una medida de su calidad:
| v0.0.4 Beta 1 | |
|---|---|
| Código | unas 1.1M líneas añadidas en main, MendCode v1 (507K) más v2 (596K) |
| Tokens | más de 30B, con caché; los 78 PRs de la v0.0.4 Beta 1 costaron unos 3B en tres días |
| Tiempo | de junio (primer commit de v1) y del 30 de septiembre (primer commit de v2) a este lanzamiento |
| Precio | gratis, Apache 2.0 |
Sigue siendo una 0.x. macOS es donde más lo he usado; Linux y Windows tienen builds y pruebas de arranque, pero menos uso real. No todas las integraciones ofrecen lo mismo.
Dejé las funciones, capturas, instalación y documentación en mendcode.dev, para no convertir este post en otro manual. Si lo pruebas, me interesa saber qué parte de tu CLI actual no querrías perder y qué cambiarías. Puedes abrir un issue, compartir un perfil o mandar código.